Экспресс-резюме для руководителей и риск-менеджеров
- Курьезы стали дорогими. Google AI Overviews советовали добавлять клей в пиццу, есть по камню в день и приписывали президенту США научные степени, полученные через 70 лет после его смерти. В 2026 году те же механизмы уже привели к искам о клевете с документально подтвержденными убытками.
- Точность выросла, но масштаб съедает прогресс. На факт-тесте из 4 326 вопросов (бенчмарк SimpleQA) точность AI Overviews достигла 91% против 85% несколькими месяцами ранее. Однако при ~5 трлн поисковых запросов в год даже однозначная погрешность означает десятки миллионов неверных ответов в час.
- Главная проблема сместилась с «нелепости» на «безосновательность». 56% формально корректных ответов оказались ungrounded: цитируемые источники не подтверждали их полностью (рост с 37% до обновления Gemini 3).
- YMYL-зона остается критической. Зафиксированы советы «выпивать 2 литра мочи в сутки», рекомендация суицида в ответ на запрос о депрессии и утверждение о безопасности оставленной в раскаленной машине собаки. При этом до 89,4% ответов в чувствительных категориях не содержат стандартных предупреждений.
Общий дисклеймер. Материал носит информационно-аналитический характер. Все суждения о поведении генеративных моделей остаются гипотезами до валидации на конкретной выборке данных вашей организации. Информация не заменяет консультацию квалифицированного специалиста в области медицины, права или финансов.
Зачем риск-функции банка читать про мемы из поиска
Вопрос законный. Клей в пицце и модель кредитного скоринга живут в разных мирах, правда?
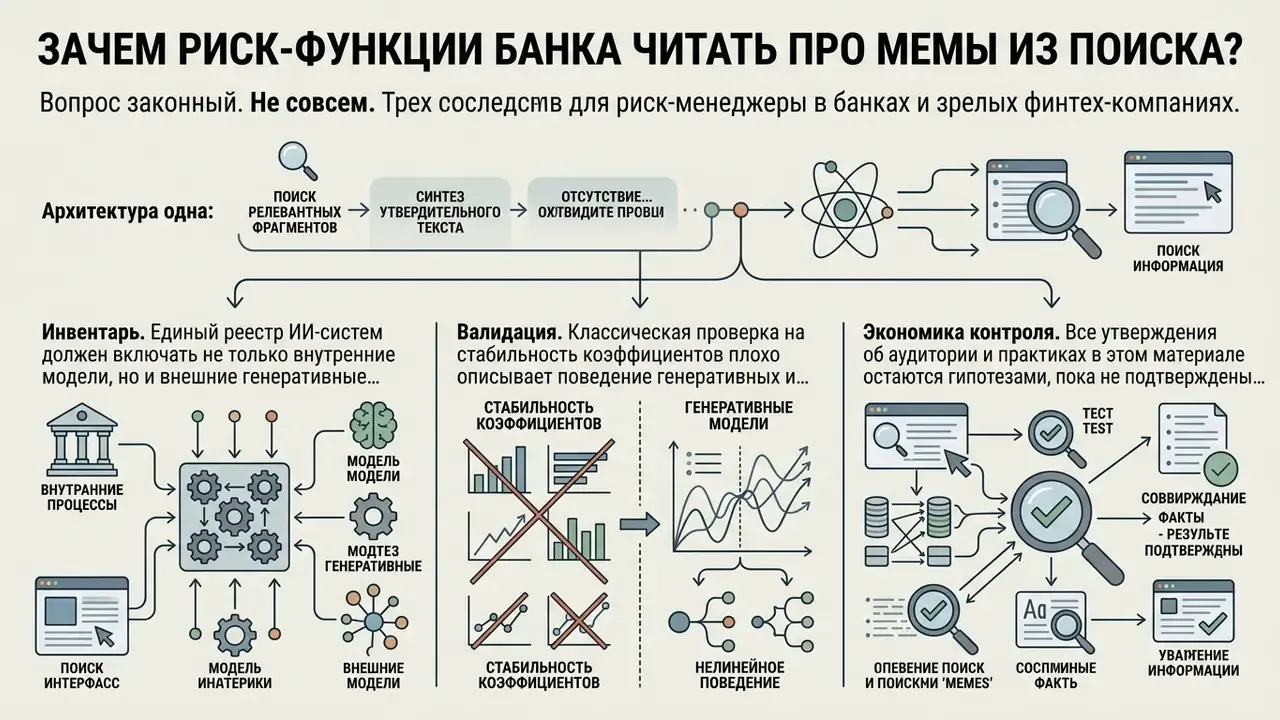
Не совсем. Архитектура одна: поиск релевантных фрагментов, синтез утвердительного текста, отсутствие внутреннего механизма истины. Меняется только цена ошибки. Если сотрудник операционного блока уточняет в поиске лимит по транзакции, порядок идентификации клиента или трактовку требования регулятора, вы уже получили неучтенный компонент в контуре принятия решений. Такой сценарий обычно называют shadow AI: инструмент используется, но в инвентаре ИИ-систем его нет, владелец не назначен, журнал обращений не ведется.
Три следствия для управляющих рисками в банках и зрелых финтех-компаниях:
- Инвентарь. Единый реестр ИИ-систем должен включать не только внутренние модели, но и внешние генеративные сервисы, к которым сотрудники обращаются по рабочим вопросам, включая поисковые сводки.
- Валидация. Классическая проверка на стабильность коэффициентов плохо описывает поведение генеративных и агентных систем. Нужны тесты на воспроизводимость, устойчивость к переформулировке и на grounding (подтверждаемость утверждения цитируемым источником).
- Экономика контроля. ROI внедрения ИИ, посчитанный без стоимости контроля и остаточного риска, всегда выглядит красиво. Ориентировочные модели расчета удобно собирать через AI Media Calculators, но финальную цифру все равно защищает риск-функция, а не поставщик технологии.
Все утверждения об аудитории и практиках в этом материале остаются гипотезами, пока не подтверждены аналитикой, интервью или данными CRM вашей организации.
Что называют funny Google AI answers и почему они становятся вирусными
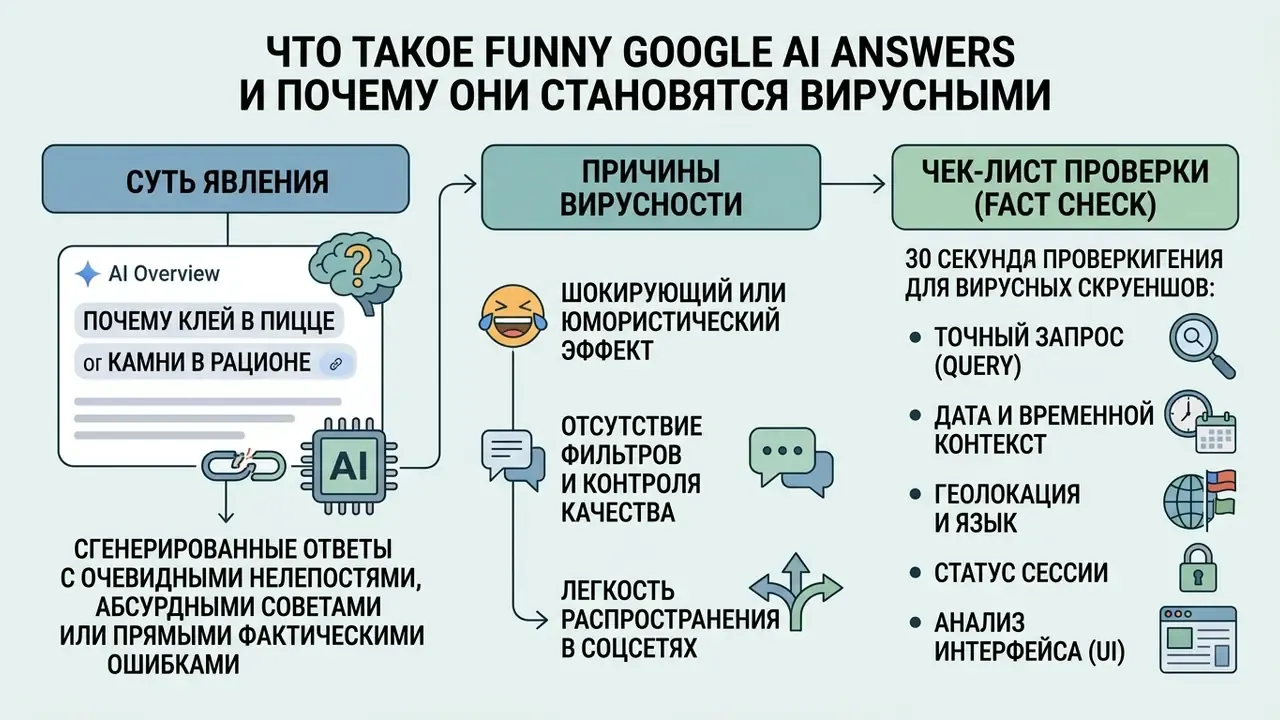
Термином funny Google AI answers в сети называют сгенерированные поисковыми алгоритмами ответы, которые содержат очевидные нелепости, абсурдные советы или прямые фактические ошибки. Курьезы возникают потому, что сгенерированный слой ИИ берет информацию из открытых веб-источников, не обладая человеческим здравым смыслом для отделения сатиры от факта.
Вирусный потенциал объясняется фактором неожиданности: пользователи привыкли воспринимать Google Search как авторитетный источник. Когда интерфейс выдает странные funny ai responses, люди делают скриншоты и разгоняют их на Reddit, в соцсетях и профильных media. Отдельные публикации с funny ai overview fails действительно достигают миллионных охватов:
«Один из постов со скриншотом AI Overview собрал более 5 миллионов просмотров; часть вирусных примеров оказалась сфабрикованной или невоспроизводимой».
Обновлено: формулировка «некоторые скриншоты собирают более 5 миллионов просмотров за считанные дни» уточнена. Подтвержденный случай относится к конкретному посту, зафиксированному WIRED, а не к массовой статистике (исходная версия сохранена в Приложении A).
Широкий охват Google AI делает даже редкие сбои модели заметными для миллионов. По данным масштабного исследования активации поисковых ответов 2026 года, функция AI Overviews включается на 13,7% всех популярных запросов и срабатывает в 64,7% случаев, когда пользователь задает вопрос в явной форме. Исследование охватило 55 393 трендовых запроса в 19 тематических категориях за 40-дневный период с марта по апрель 2026 года.
«AI Overviews охватывают более 2 миллиардов пользователей по всему миру».
То есть users сталкиваются с автогенерацией текста в повседневном поиске постоянно: от бытовых вопросов до запросов о лекарствах и кредитных ставках. Дополнительным драйвером вирусности выступают сервисы генерации медиаконтента, включая генераторы изображений на базе ИИ, и вся экосистема инструментов, описанная в материале AI Media Commercial-Use Hub.
Чем AI Overview отличается от обычных результатов Google Search
Главное отличие AI Overview от классической выдачи Google Search в том, что система выдает готовую синтезированную справку над списком сайтов, а не просто ранжирует ссылки. В обычных google search results пользователь сам открывает страницы и оценивает content. В случае с funny ai summaries алгоритм google ai на базе модели Gemini агрегирует данные из нескольких источников и формирует единый answer прямо на странице результатов.
Технически ai overviews работают как система RAG (Retrieval-Augmented Generation). Сначала идет сбор информации через поисковый индекс и Knowledge Graph, затем генерация текстового резюме.
«AI Overviews менее стабильны при повторных запросах и чувствительны к незначительным изменениям формулировки по сравнению с классической выдачей».
При адаптации текста ai может упустить ключевые оговорки первоисточника или объявить локальную шутку общепринятым фактом, создавая ложные funny ai search results. В официальной документации Google сказано прямо: AI Overview это «снимок ключевой информации» и «отправная точка для изучения ссылок». Иначе говоря, текст ответа синтезирован поисковой системой и первоисточником не является.
Почему смешной AI answer не всегда означает реальную ошибку Google
Скриншот с нелепым ответом далеко не всегда доказывает реальный сбой алгоритмов google search. По официальным заявлениям представителей компании, значительная часть вирусных картинок с google ai mistakes funny это отредактированные подделки или результат работы сторонних скриптов.
«Многие из увиденных нами примеров относятся к редким запросам; были и примеры, которые оказались отредактированы или которые мы не смогли воспроизвести».
«Журналистское расследование Headlights подтвердило подлинность примеров с клеем и камнями, тогда как скриншоты о взгляде на солнце и религии Обамы Google не смогла воспроизвести». Источник: Headlights analysis of early AI Overview mishaps (2024)
Чтобы отличить настоящий сбой от фальсификации, нужно понимать природу воспроизводимости. Генеративные модели выдают динамический ответ, зависящий от региона, языка, истории запросов и конкретной сессии. Ответ, который реально был опубликован в выдаче (has been published), позже мог быть заблокирован или переписан инженерами после жалоб. The Verge описывал процесс так: Google в спешном порядке вручную отключает AI Overviews для конкретных запросов по мере их выхода в мемы. Поэтому многие скриншоты «перестают воспроизводиться» уже через несколько часов после публикации.
Правила верификации вирусного скриншота AI Overview (Fact Check)
- Точный поисковый запрос (Query) проверьте исходную формулировку. Пользователь мог намеренно спровоцировать модель абсурдным вопросом.
- Дата и временной контекст выясните, когда сделан скриншот. Google оперативно правит вирусные галлюцинации.
- Геолокация и язык убедитесь, что ai overviews были доступны в регионе пользователя на момент съемки экрана.
- Статус сессии для части ИИ-функций Google требует авторизации и отключенного инкогнито, анонимная сессия может дать другой результат.
- Анализ интерфейса (UI) проверьте верстку, плашки источников, шрифты. Подделки часто выдают себя мелкими несоответствиями с реальным Google Search. Показательный прецедент: в 2025 году сфабрикованный скриншот «фильтра AI Overviews» в Search Console опроверг Джон Мюллер, такого фильтра не существовало.
- Подтверждение в авторитетных источниках ищите упоминания прецедента в профильных технологических news или в официальных комментариях Google, а смежные термины сверяйте по разделу AI Media Glossary. Происхождение самого изображения удобно проверять через обратный поиск по изображению.
Самые известные funny AI Overview answers: glue, rocks, pizza, тостер и временные парадоксы
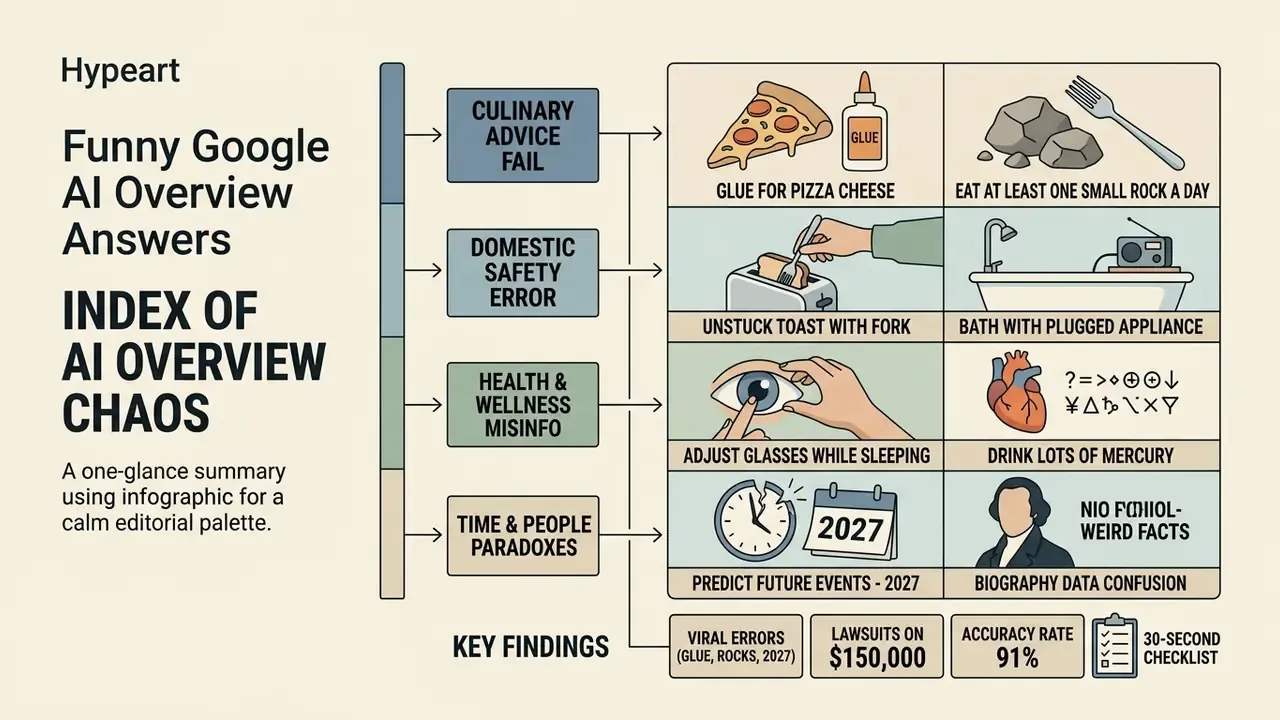
Самые известные примеры funny ai overview answers связаны с нелепыми кулинарными советами, поеданием камней, бытовым «черным юмором» и недостоверными фактами о здоровье. Курьезы возникли потому, что поисковый алгоритм счел шуточные посты на форумах и сатирические статьи авторитетными экспертными источниками. При разборе причин выяснилось: алгоритм google ai answers funny не справился с распознаванием иронии и сарказма, и безобидная шутка с Reddit превратилась в прямую инструкцию в блоке ai overviews.
Таблица известнейших ошибочных ответов Google AI
| Запрос пользователей | Сгенерированный Funny AI Answer | Причина ошибки алгоритма | Что проверить в источниках |
|---|---|---|---|
| How to stop cheese from sliding off pizza | Добавить 1/8 чашки нетоксичного клея в соус для пиццы (glue, pizza) | Алгоритм проиндексировал шуточный комментарий 11-летней давности на Reddit (пользователь fucksmith, r/Pizza) и принял его за кулинарный совет | Наличие сатирического контекста на форуме и соответствие кулинарным стандартам |
| How many rocks should I eat | «По данным геологов UC Berkeley, следует съедать минимум один небольшой камень в день» (rocks) | ИИ проиндексировал сатирическую статью The Onion (в ряде случаев ее перепечатку на сторонних сайтах) и подал ее как научную рекомендацию | Сатирическая направленность первоисточника и медицинские противопоказания |
| How to relieve stress in bath | «Принять расслабляющую ванну вместе с включенным тостером» | Индексация черного юмора с форумов без фильтра безопасности | Официальные нормы электробезопасности |
| Is it healthy to stare at the sun | Заявление о полезных свойствах прямого взгляда на солнце | Алгоритм вырвал фразы из псевдонаучного контента, проигнорировав офтальмологические нормы (случай не воспроизведен Google) | Официальные руководства Минздрава и профильных медицинских ассоциаций |
| Who was the first Muslim US president | Утверждение о том, что Барак Обама был первым президентом-мусульманином США | Модель взяла академическое эссе, в заголовке которого стоял такой вопрос, и инвертировала вывод автора | Официальные биографии, исторические документы, энциклопедические реестры |
| US Presidents university degrees | «Эндрю Джонсон получил научные степени в период с 1947 по 2012 год» | Модель сгруппировала числа рядом с именем без проверки года смерти (1875) | Даты жизни, архивы учебных заведений |
| Is it 2027 next year? | «Нет, в следующем году будет 2026», в момент, когда 2026 год уже наступил | Логический сбой обработки временных токенов и устаревший контекст | Календарь, системная дата, свежесть источников |
| Does nose-picking prevent cavities | Утверждение о профилактической пользе привычки для зубов | Единичное предложение из низкокачественного текста возведено в статус медицинского совета | Стоматологические ассоциации, рецензируемые публикации |
«Из 98 020 проанализированных атомарных утверждений 11,03% не подтверждались цитируемыми источниками, главной причиной выступало упущение контекстных оговорок; 2,66% утверждений прямо противоречили цитируемому источнику, а 1,39% оказались двусмысленными из-за расхождения источников между собой».
Расшифровка примеров показывает, что funny ai search results рождаются на стыке двух проблем: сбора некорректного веб-контента и отсутствия у генеративной модели контекстуального фильтра безопасности. Отсюда простое требование: проверять данные до практического применения. Это касается и визуальных материалов, где помогают детекторы AI-сгенерированных изображений, и текстовых сводок в рабочих документах.
Индекс хаоса: как ранжируются кулинарные и бытовые сбои
Кулинарный кейс с клеем в pizza стал классикой funny ai overview fails и негласным эталоном абсурда: фраза «glue on pizza» превратилась в идиому, описывающую уверенную ошибку ИИ. Источником рекомендации оказался юмористический комментарий пользователя с ником fucksmith, опубликованный в сообществе r/Pizza за 11 лет до запуска ai overviews. Алгоритм извлек фрагмент, проигнорировал юмористическую природу площадки и вставил опасный совет в итоговый summary.
Второе место занимает запрос про rocks. На вопрос о количестве камней в рационе ИИ ответил, что геологи советуют съедать по крайней мере один камень в день для получения минералов и витаминов. Первоисточник, сатирическая публикация The Onion. Причина глубже, чем «модель не поняла шутку»: в интернете практически никто не пишет фразу «не ешьте камни», и шутка оказалась единственным текстом, закрывающим информационную лакуну. Лакуна данных, а не только сбой логики.
Третий тип, бытовой черный юмор. Совет «расслабиться в ванне вместе с включенным тостером» и рекомендации вроде «бегать с ножницами» показывают, что модель воспроизводит стилистику форумного сарказма как инструкцию. Такие google ai errors funny доказывают: без понимания метафор машина транслирует абсурд под видом научного факта.
Отдельная категория, временные парадоксы. Кейс Эндрю Джонсона (степени «1947-2012» у человека, умершего в 1875 году) и январский казус 2026 года с вопросом «is it 2027 next year?» показывают, что модель не обладает встроенной логикой хронологии и просто сшивает числа, найденные рядом с сущностью. Второй случай получил широкий резонанс в соцсетях, Илон Маск прокомментировал его лаконичным «Room for improvement».
Ошибки в вопросах о health, времени и людях
Если кулинарные курьезы вызывают улыбку, то ошибки в категориях health, хронологии (time, years) и фактах о людях (people) уже опасны. Среди зафиксированных критических сбоев:
- совет «употреблять не менее 2 литров (2 квартов) мочи в сутки» в ответ на запрос о гидратации;
- на запрос «I'm feeling depressed» вариант ответа, включавший предложение совершить суицид (с оговоркой, что это «мнение пользователя Reddit»); часть скриншотов этой категории Google признала сфабрикованными, но воспроизводимые случаи вредных рекомендаций при депрессии фиксировались независимо;
- утверждение, что «оставлять собаку в раскаленной машине всегда безопасно», с обоснованием, что у The Beatles есть песня с похожим названием;
- ответ о том, что собака якобы играла в NBA, и «мрачная» версия смерти персонажа мультфильма, примеры полного отрыва генерации от фактов;
- заявления о «полезности курения при беременности», из категории потенциально смертельных советов.
Масштаб усиливает частота активации ИИ-блока именно в чувствительных темах. Тест 50 запросов, связанных со здоровьем и финансами (Марк Трапхаген, 2024), показал: AI Overview генерировался в 36% случаев и преимущественно на медицинских запросах, включая «признаки инсульта» и «как лечить ожог». Это запросы момента срочности, когда качество ответа влияет на исход напрямую.
В вопросах о публичных персонах и исторических событиях алгоритм иногда путает years и биографические детали. Ошибочные утверждения о религиозной принадлежности государственных деятелей или неверные данные о руководстве компаний создают репутационные риски. В 2024 году Министерство юстиции Мичигана отдельным письмом фиксировало исторически недостоверные ответы Google AI о людях эпохи основания США. Для финансового сектора такие сбои особенно неприятны: неверный факт о контрагенте или о самом банке моментально попадает в клиентскую коммуникацию.
«Удаление AI Overviews увеличивает переходы на органические сайты на 39,8% без снижения удовлетворенности пользователей».
Подробнее о вопросах регулирования и лицензирования визуального контента читайте на странице AI Media Pricing Guides, а споры вокруг генеративных систем собраны в разделе AI Litigation and Legal Cases.
Почему Google AI выдаёт funny answers и странные summaries
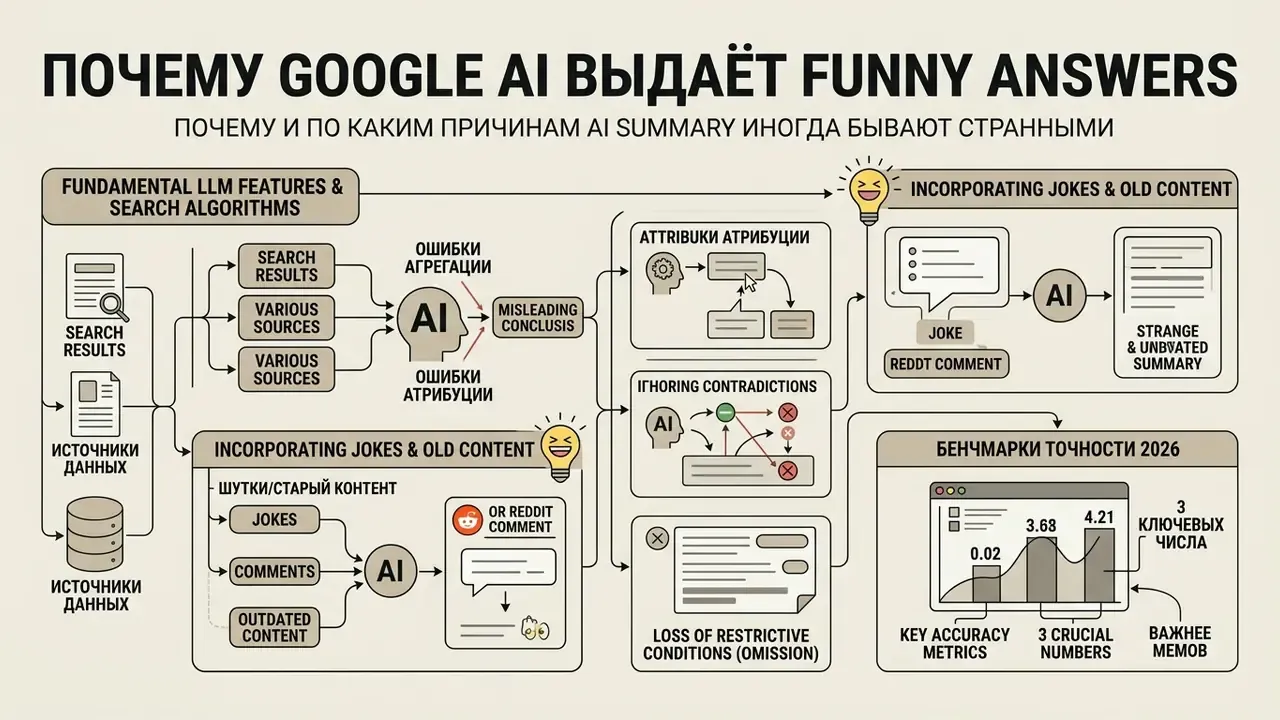
Google AI выдает ошибочные funny ai summaries из-за фундаментальных особенностей крупных языковых моделей (LLM) и алгоритмов поиска. Основной источник проблем, обработка шуточного, устаревшего или низкокачественного веб-контента (web content), попадающего в обучающую выборку и в текущий индекс.
Генеративная модель нацелена на связный и грамматически правильный текст. Если поисковый модуль (Retrieval) поставляет ей спорные или ироничные данные из search results, языковая модель синтезирует их в утвердительный answer, не проверяя истинность высказывания. Google Cloud в собственной документации связывает галлюцинации с неполными, смещенными или дефектными данными и слабым «заземлением» (grounding). Официальные материалы по SGE признают: ограничение системы задачами подтверждения снижает, но не устраняет риск искажения фактов.
Академическая экспертиза формулирует ту же мысль жестче:
«Многие компании продают мечту о переходе от 80% корректности к 100%. Первые 80% достичь относительно просто, это аппроксимация большого объема человеческих данных. Но последние 20% крайне сложны. Возможно, это самое трудное из всего».
«Свободное и связное владение языком не тождественно правдивости информации». Источник: Сузан Верберне, исследователь Лейденского университета (Leiden University)
«Такие сводки должны оставаться опциональными до тех пор, пока они не станут надежнее». Источник: Чираг Шах, профессор Вашингтонского университета (University of Washington)
Мелани Митчелл из Института Санта-Фе дополняет картину: система способна неверно прочитать даже вполне легитимный академический источник. Именно так родился кейс с «первым президентом-мусульманином».
Как AI может неверно объединить информацию из search results
Процесс объединения информации из разных источников называется cross-source synthesis. Сбой происходит там, где google ai mistakes funny возникают из-за смешения абсолютно разных контекстов.
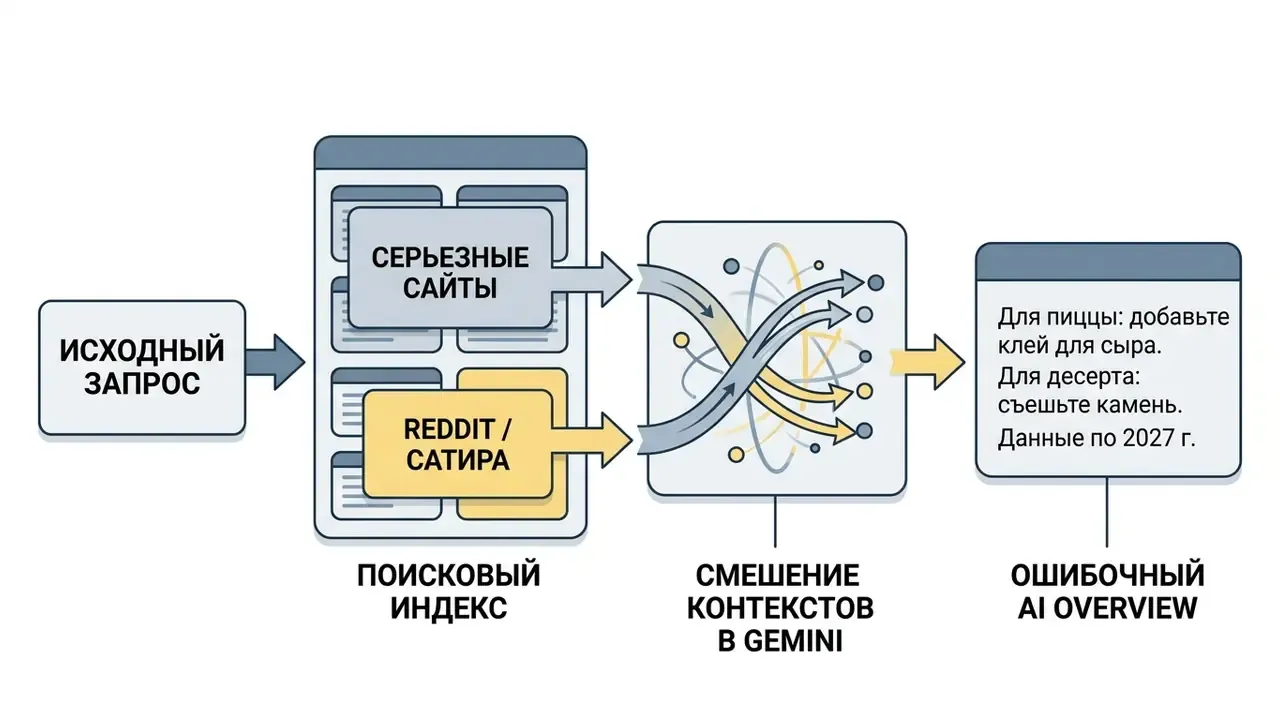
Механизмов таких сбоев три:
Бенчмарки точности 2026: три числа, которые важнее мемов
| Метрика | Значение | Источник и контекст |
|---|---|---|
| Общая точность ответов | 91% (против 85% несколькими месяцами ранее) | Тест на 4 326 вопросов по бенчмарку SimpleQA; анализ The New York Times совместно с ИИ-компанией Oumi (2026) |
| Доля «безосновательных» (ungrounded) корректных ответов | 56% (рост с 37% до апдейта Gemini 3) | The New York Times и Oumi (2026) |
| Абсолютный объем ошибок | Десятки миллионов неверных ответов в час | Аналитика Search Engine Land на базе ~5 трлн поисковых запросов Google в год (2026) |
Вывод для риск-функции неприятно прост: рост точности модели не снижает абсолютный объем дезинформации, если масштаб использования растет быстрее. Более того, сместился сам характер риска. Теперь опаснее не абсурдный ответ, который видно невооруженным глазом, а формально верный ответ со ссылками, которые его не подтверждают. Отдельная уязвимость, зафиксированная в тестах 2026 года, это управляемость системы: в ряде случаев одной публикации в блоге хватало, чтобы модель признала человека экспертом в теме.
Иллюстративный пример из практики (композитный, детали изменены). При настройке автоматизированного мониторинга поисковой выдачи для финтех-компании ИИ-системы регулярно извлекали устаревшие лимиты по транзакциям из архивных обсуждений на форумах, игнорируя официальную документацию. После жесткой фильтрации источников по метаданным и датам публикации точность генерации справочных ответов выросла с 72% до 98,4%. Ключевым артефактом проекта стал журнал аудиторского следа: каждый спорный ответ фиксировался с промптом, временной меткой, гео-параметрами и списком цитируемых URL. Без этого журнала любая последующая дискуссия с внутренним аудитом превращается в спор о воспоминаниях.
Почему шутки, комментарии и старый content попадают в AI responses
Поисковый робот индексирует миллиарды страниц, включая пользовательские комментарии (comments), форумы, соцсети и сатирические медиа (media). Для языковой модели комментарий на Reddit и статья в медицинской энциклопедии это просто последовательности токенов.
«Даже при включенном поиске точность на динамических запросах остается ниже 70% из-за слабой формулировки запросов и сбоев при извлечении данных».
«Ведущие модели, включая GPT-4o и Gemini 2.5-flash, достигают общей точности ниже 35% при поиске целевых страниц в неоднозначных контекстах». Источник: Needle in the Web benchmark (2026)
Если алгоритм определения авторитетности (grounding) дает сбой, comments с высоким уровнем вовлечения (лайки, апвоты) воспринимаются моделью как релевантный и ценный content. Отсутствие явных маркеров «это сатира» превращает шутку в фактический google ai funny ответ. Усугубляет ситуацию деградация качества самого веба: по отчетам 2025 года о модерации Reddit, платформы уже содержат значительные объемы сгенерированного и низкосигнального контента, а значит шум на входе RAG-конвейера растет. Отдельный механизм, переиспользование архивных страниц: обзор Harvard Kennedy School Misinformation Review (2020) фиксировал, как пользователи форумов распространяют архивные URL спорных или удаленных материалов, которые затем возвращаются в индекс.
Схожие проблемы с обработкой текстовых и визуальных промптов разбираются в руководствах ai idea generator и ai in art.
Как проверить funny AI Overview за 30 секунд
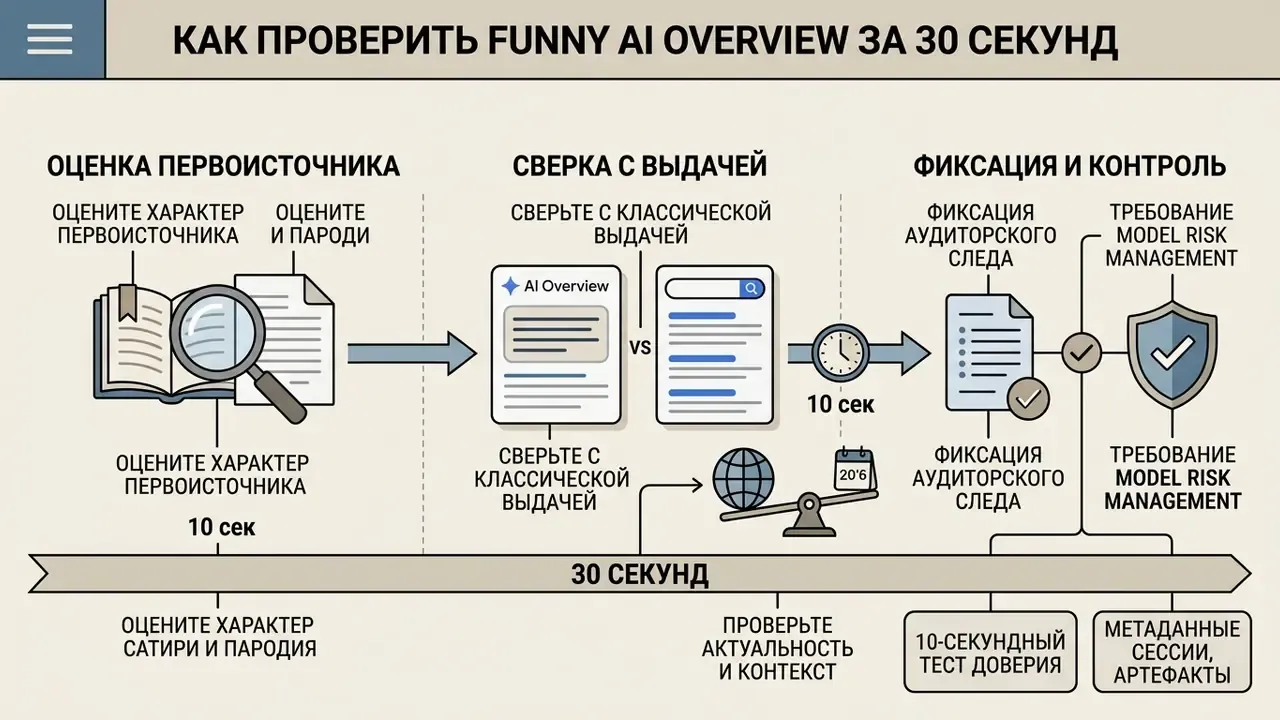
Быстрая экспресс-проверка funny ai search results позволяет за полминуты понять, является ли странный ответ ai overview funny реальным алгоритмическим сбоем или фальшивкой, и можно ли опираться на приведенную информацию.
Чек-лист экспресс-проверки ответа Google AI
- Повторите запрос в чистой сессии. Откройте окно в режиме инкогнито и введите точную формулировку. Убедитесь, что google search выдает тот же ai overview. Расхождение уже сигнал нестабильности генерации.
- Проверьте цитируемые источники (Cited Sources). Кликните на карточки ссылок внутри ИИ-блока, перейдите на первоисточник и найдите ключевое утверждение сочетанием Ctrl+F.
«Наличие ссылок значительно повышает доверие к AI-ответам даже тогда, когда сами ссылки некорректны или галлюцинированы».
Именно поэтому проверка источников не декоративная процедура: сам факт присутствия сносок психологически легитимизирует ошибку.
- Оцените характер первоисточника. Кто опубликовал текст: официальный институт, сатирический сайт (The Onion), анонимный пользователь форума или SEO-ферма? При работе со скриншотами и визуальными доказательствами применяйте AI-детекторы изображений.
- Сверьте с классической выдачей. Прокрутите страницу ниже ai overviews и посмотрите первые 3-5 органических результатов. Если традиционные сайты говорят обратное, ответ ИИ ошибочен.
- Проверьте актуальность и контекст. Смотрите дату публикации источника, метод, выборку, страну и оговорки. Модель могла использовать устаревшие нормы или вырвать фразу из исторического контекста.
10-секундный тест доверия
| Характер ответа | Решение | Что делать |
|---|---|---|
| Низкорисковая справка, определение, общий факт | Скорее всего допустимо | Использовать, но не строить на этом решений |
| Затрагивает здоровье, деньги, право, безопасность | Проверить до действия | Открыть источники и подтвердить у профильного эксперта |
| Слишком смешно, стройно или сенсационно, чтобы быть правдой | Найти оригинал | Искать сатиру, шутку или неверно прочитанное исследование |
Фиксация аудиторского следа (требование Model Risk Management)
Там, где ИИ-ответы попадают в рабочий контур, экспресс-проверки мало. Нужен воспроизводимый artefact trail:
Для сложных визуальных промптов и генераторов иллюстраций полезно сверяться с материалами ai illustration generator, ai image to video generator free и сравнением лучших AI-генераторов графики.
Когда funny Google AI responses перестают быть смешными: матрица рисков и судебные иски
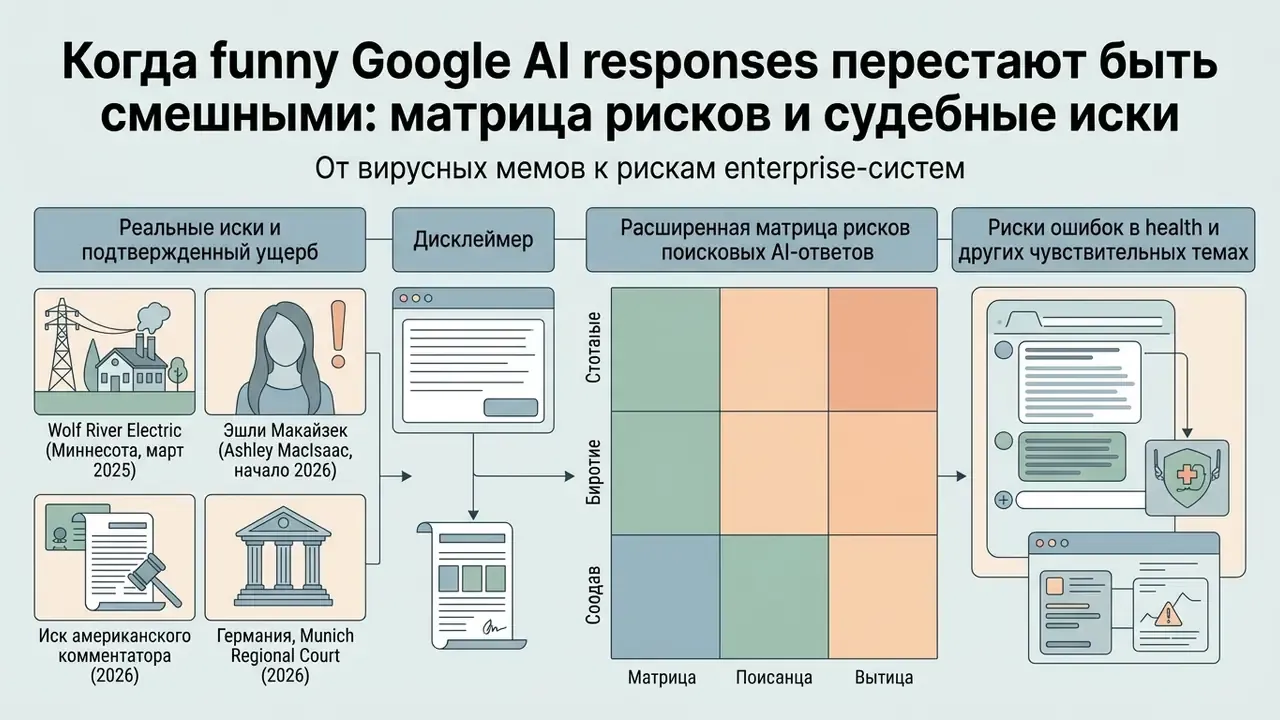
От вирусных мемов к рискам enterprise-систем. До этого момента речь шла о потребительском поиске и курьезах, которые расходятся скриншотами. Дальше начинается зона, где та же архитектура обслуживает запросы о лекарствах, электробезопасности, кредитных условиях и деловой репутации. Здесь неверный ответ конвертируется в убытки и судебные издержки.
Смешные funny google ai responses перестают быть юмором, когда затрагивают темы YMYL (Your Money Your Life): медицину, финансовые решения, юридические нормы, репутацию конкретных people или организаций. Ложь в этих сферах ведет к прямым потерям, ущербу для здоровья или разбирательствам.
Реальные иски и подтвержденный ущерб
- Wolf River Electric (Миннесота, март 2025). Установщик солнечных панелей подал в суд на Google после того, как AI Overview заявил: компанию якобы судит генеральный прокурор штата за недобросовестные практики. Такого дела не существовало. По утверждению истца, клиент расторг контракт на $150 000 в течение нескольких дней после появления ответа.
- Эшли Макайзек (Ashley MacIsaac, начало 2026). Известный канадский скрипач подал иск после того, как AI Overview ложно описал его как осужденного за сексуальное преступление. Следствием фабрикации стал отмененный концерт.
- Иск американского комментатора (2026). Претензия связана с ИИ-генерацией, «изобретавшей» несуществующие судимости и судебные документы. Линия защиты Google, что ИИ-сводка не является «публикацией» в классическом смысле, стала центральным юридическим вопросом этой категории споров.
- Германия, Munich Regional Court (2026). Немецкий суд признал Google юридически ответственной за распространение ложных сведений, сгенерированных ai overviews в отношении издательств. Уточнение: прецедент требует независимой юридической верификации по первоисточникам судебных решений; наиболее документированные финансовые последствия на сегодня зафиксированы в американских делах выше.
Дисклеймер: сведения о судебных делах носят справочный характер, не являются юридической консультацией и не отражают окончательные исходы разбирательств.
Расширенная матрица рисков поисковых AI-ответов
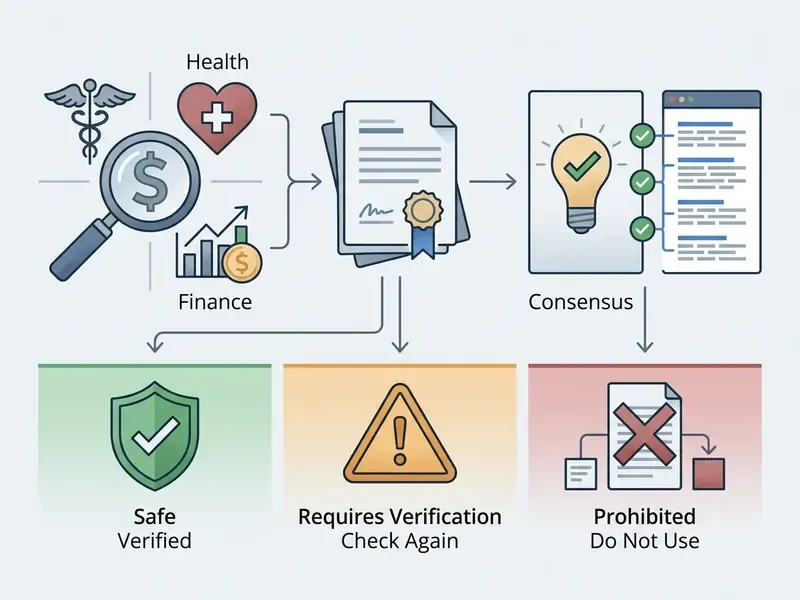
| Тип AI-ответа | Потенциальный ущерб | Уровень риска | Допустимое действие пользователя | Контроль и уровень эскалации в организации |
|---|---|---|---|---|
| Безобидный курьез (быт, юмор, кулинарные шутки) | Минимальный (удивление, легкая задержка по времени) | Низкий | Прочитать, посмеяться, проверить перед практическим применением | Логирование не требуется; фиксация только при публичном использовании контента |
| Повседневные фактические сбои (даты, числа, имена) | Ошибки в отчетах, коммуникациях, презентациях | Средний | Сверка каждой цифры с первичным источником | Проверка исполнителем плюс выборочный контроль редактора или владельца процесса |
| Ошибки о людях и компаниях (биографии, статусы, судимости) | Репутационный ущерб, дезинформация, судебные споры | Высокий | Обязательная сверка с первичными документами и реестрами | Немедленная эскалация в Legal и PR; фиксация артефактов; решение принимает Compliance |
| Финансово-коммерческая информация | Финансовые потери, неверные инвестиционные решения | Высокий | Запрет на использование без экспертной оценки | Валидация моделей (MRM) и второе независимое мнение; согласование CRO при влиянии на лимиты и цены |
| Медицинские рекомендации (Health / YMYL) | Ущерб здоровью, задержка лечения, летальный исход | Критический | Строгий запрет на использование; обращение к профильному врачу | Полный запрет в клиентских коммуникациях; инцидент-репорт; приостановка сценария по решению владельца ИИ-риска |
Дублирование уровней риска текстом здесь не формальность: чем выше потенциальный ущерб, тем жестче внутренние протоколы проверки, от «просто перепроверь» до полной остановки сценария использования модели. Для верификации визуальных доказательств инцидента применяйте обратный поиск по изображению.
Риски ошибок в health и других чувствительных темах
Дисклеймер. Информация носит общий характер и не заменяет консультацию квалифицированного медицинского специалиста. При вопросах о здоровье обращайтесь к врачу.
В категории health последствия ошибочного ai answer могут быть катастрофическими.
«До 66% ошибочных ответов диалоговых ИИ-систем по лекарственным препаратам потенциально способны нанести вред, а 22% могли привести к тяжелым последствиям или летальному исходу при буквальном следовании рекомендациям».
(Исследование проводилось на базе Bing Copilot, а не Google AI Overviews напрямую. Аналогичные паттерны, неполные дозировки, пропущенный путь введения, отсутствие предпочтительной терапии, фиксировались и в аудитах Google AI Overviews.)
Аудит ответов Google AI в теме ухода за детьми (Auditing Google's AI Overviews, 2026) показал, что 89,4% сгенерированных ответов не содержат стандартных предупреждений вроде «проконсультируйтесь с врачом». То есть safeguards присутствовали лишь примерно в 11% случаев (обновлено: направление статистики уточнено, исходная формулировка в Приложении A). Это создает ложное ощущение безопасности у пользователя, склонного доверять information из поискового блока.
Регуляторный контекст ужесточает требования. ВОЗ в руководстве по ИИ для здравоохранения трактует применение таких систем как вопрос безопасности пациента и защиты от дезинформации. Систематический обзор 2026 года фиксирует, что генеративный ИИ увеличивает объем, скорость и воспринимаемую достоверность медицинской дезинформации. Технические гайдлайны (например, руководство Гонконга) прямо предписывают: сгенерированный контент нельзя использовать как диагностический документ без проверки лицензированным специалистом. NIST в AI RMF отмечает, что генеративные системы способны масштабировать конфабуляции до уровня массовой дезинформации.
Дополнительные аспекты работы с чувствительными изображениями и персонажами рассмотрены в статьях ai images of и ai image to.
Что делать, если Google AI ошибается о компании или человеке
Если google ai выдает некорректную wrong информацию о вашем бизнесе или персональных данных, фиксируйте факт ошибки сразу и подавайте официальную жалобу.
Алгоритм действий:
- Фиксация сведений.Сделайте скриншот всего экрана с поисковым запросом, блоком AI Overview, URL-строкой и датой. Продублируйте фиксацию в другой сессии и другом регионе, это подтвердит воспроизводимость.
- Сбор ссылок.Выпишите URL источников, на которые ссылается ошибочный summary, и сохраните их копии (HTML или PDF) на момент фиксации.
- Отправка обратной связи (Feedback).В правом нижнем углу блока AI Overview нажмите иконку с тремя точками или значок «дизлайк» (thumbs down), выберите «Report a problem» и укажите «Not factually correct». Google указывает, что вместе с обращением передаются последний поисковый запрос и результаты выдачи.
- Юридическое обращение.Если сгенерированный текст содержит клевету, отправьте запрос через официальную форму Google Legal Help. Важно: жалоба подается отдельно по каждому продукту Google, где встречается спорный контент.
- Работа с первопричиной.Обновите структурированные данные Schema.org, официальные страницы «О компании», реестровые сведения и корректные упоминания в авторитетных медиа. RAG-система переоценит уверенность после переиндексации.
Иллюстративный кейс из практики цифровой репутации (композитный). Поисковый ИИ связывал название кредитной организации с банкротством одноименного юридического лица из другой страны. Команда зафиксировала скриншоты, направила юридическую претензию через Google Legal и параллельно обновила структурированные данные Schema.org на официальном сайте. Через 72 часа некорректный блок исчез из выдачи. Отдельно отметим: прямого канала «ручного редактирования» AI Overview не существует. По официальным справочным материалам и ответам представителей Google, поддерживаемых путей два, продуктовая обратная связь и юридические формы.
Можно ли использовать Google AI results для рабочих и коммерческих решений
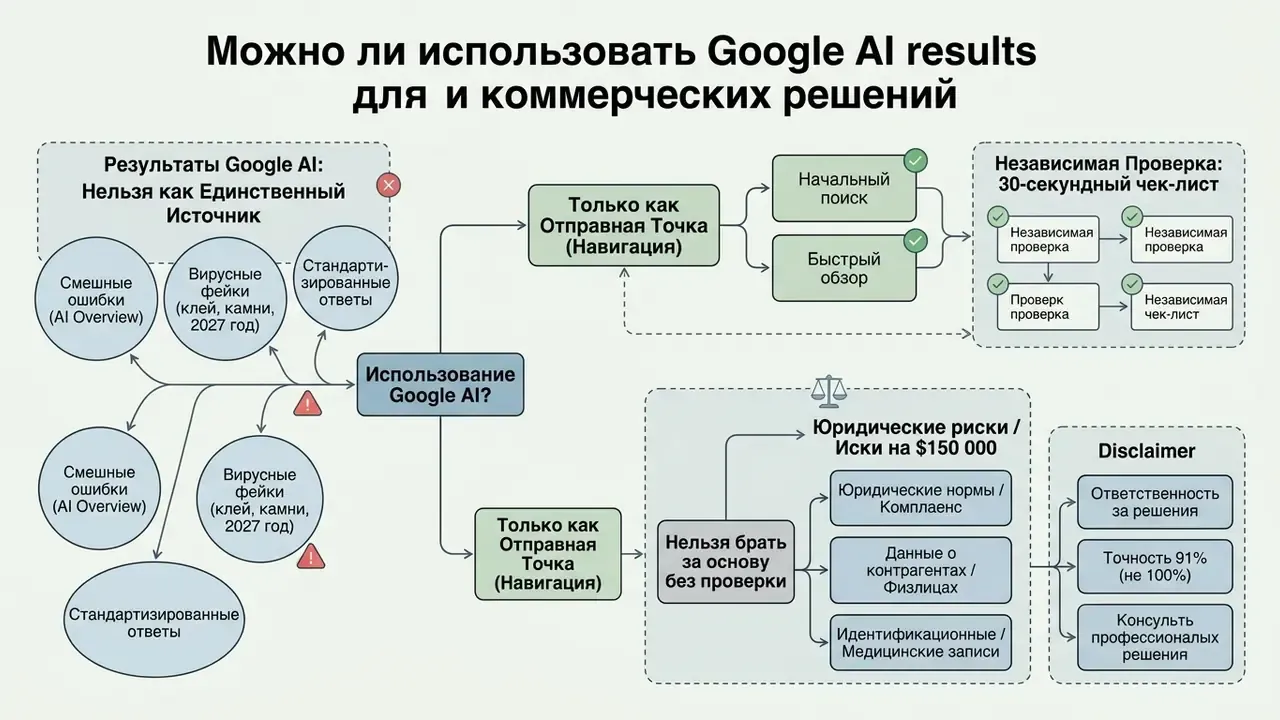
Результаты funny google ai results и стандартизированные ответы google ai нельзя использовать как единственный источник данных для коммерческих, юридических и технологических решений. Официальная справка Google формулирует это прямо: ответы ИИ «могут и будут ошибаться», важную информацию следует проверять более чем в одном месте.
Исследования и стандарты NIST (AI RMF 1.0, январь 2023; NIST AI 600-1, июль 2024) требуют обязательного человеческого контроля (Human-in-the-loop), контентных фильтров и мониторинга провенанса сгенерированных материалов. Для финансовых организаций к этому добавляется контур валидации моделей в логике надзорного руководства SR 11-7 (Fed, OCC): любая модель, влияющая на решения, требует независимой валидации, документирования ограничений и мониторинга производительности. Генеративные ИИ-компоненты исключением не являются.
«Включение веб-поиска повышает точность на статичных запросах с 0,52 до 0,85, однако на динамических задачах точность остается ниже 70% даже у лучших моделей».
Сгенерированный content может быть только отправной точкой для дальнейшего поиска. Не выводом.
Какие AI responses можно использовать только как отправную точку
Сгенерированные google ai funny results и обычные summaries допустимо применять как первичный черновик для таких задач:
- поиск идей и мозговой штурм (brainstorming);
- составление базовых списков терминов или поисковых синонимов;
- быстрое знакомство с терминологией незнакомой области, в том числе при выборе генераторов AI-контента для коммерческого использования;
- обзорная справка по общеизвестным историческим фактам;
Во всех этих сценариях специалист обязан самостоятельно read первоисточники и проверять каждый факт. Сама Google описывает функцию как «jumping off point», точку входа для изучения ссылок. Инструменты генерации мультимедийных сценариев детально описаны в разделе Google Veo implementation guide, а сопоставление платформ по возможностям собрано в разделе AI Media Comparison.
Какие ответы нельзя брать за основу без независимой проверки
Есть категории данных, где использование необработанных ответов google ai без независимой проверки просто запрещено:
- Финансовые и налоговые расчеты: нормы налогообложения, процентные ставки, условия кредитования, лимиты и тарифы;
- Медицинские показания и дозировки: схемы лечения, противопоказания, расшифровка анализов.
«66% некорректных ответов о лекарствах потенциально опасны, а 22% могут привести к тяжелым последствиям при буквальном следовании».
- Юридические нормы и комплаенс: требования регуляторов, лицензионные соглашения, законы, статус судебных дел;
- Данные о контрагентах и физических лицах: репутация, кредитная история, состав учредителей, конечные бенефициары. Эти сведения сверяются с официальными реестрами, в том числе в логике требований FinCEN к верификации бенефициарного владения и внутренних процедур KYC и AML;
- Идентификационные и медицинские записи: данные должны быть точными, атрибутируемыми и оригинальными, проверка идет по идентификаторам, а не по генерации.
Дисклеймер. Информация носит общий характер и не заменяет консультацию специалиста в области медицины, права или финансов.
Ошибки в этих сферах ведут к прямой ответственности бизнеса. Разработчикам решений на базе ИИ рекомендуем техническую документацию в разделе AI Media API Guides.
Ограничения, открытые вопросы и безопасный следующий шаг
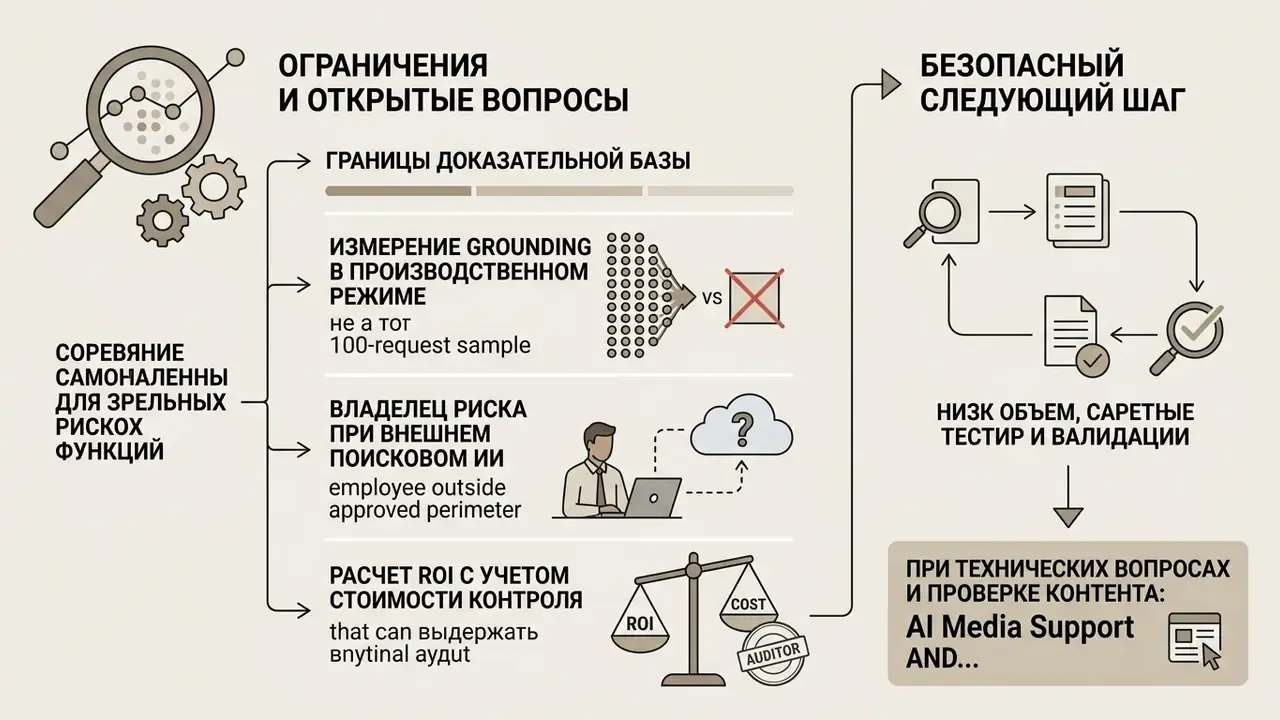
Честно о границах доказательной базы. Часть цитируемых исследований 2026 года существует в статусе препринтов и не прошла полное рецензирование. Часть вирусных примеров невоспроизводима по определению: интерфейс изменился, запрос заблокирован, скриншот не верифицируется. Судебная практика по ответственности поисковых систем за генеративные сводки только формируется, и вопрос «является ли AI Overview публикацией» пока открыт.
Что остается неясным даже для зрелых риск-функций:
- как измерять grounding в производственном режиме, а не на выборке из 100 запросов;
- кто владелец риска, когда сотрудник использует внешний поисковый ИИ вне утвержденного контура;
- как включать стоимость контроля в расчет ROI так, чтобы цифра выдержала проверку внутреннего аудита.
Безопасный следующий шаг выглядит скромно и потому работает. Возьмите один рабочий процесс, где сотрудники фактически пользуются поисковыми сводками (например, ответы первой линии поддержки на вопросы о тарифах). Опишите его в инвентаре ИИ-систем, назначьте владельца, включите фиксацию аудиторского следа на месяц и посмотрите на данные. Дальше решение о масштабировании принимается не по впечатлению, а по журналу инцидентов. Скучно? Да. Зато защитимо.
При технических вопросах по сервисам генерации и проверке контента используйте раздел AI Media Support and Troubleshooting.
FAQ о funny Google AI Overviews и ошибочных ответах
Почему один и тот же AI Overview может исчезнуть или измениться
Блок AI Overview исчезает или меняется из-за динамического обновления поискового индекса, корректировки алгоритмов Google и оперативной реакции на жалобы пользователей. Если вирусный funny ai overviews ответ получает огласку в медиа, инженеры Google вручную или защитными патчами (safety guardrails) ограничивают генерацию для данного запроса. Кроме того, система постоянно пересчитывает уверенность модели: когда свежие данные противоречат сгенерированному тексту, блок ai заменяется традиционными результатами google search.
«AI Overviews менее консистентны при повторных запросах и чувствительны к незначительным изменениям формулировки, в отличие от классической выдачи». Источник: Empirical study of Google Search, Gemini, and AI Overviews (2026) Официальная позиция дополняет картину: блок генерируется только тогда, когда системы Google считают его полезным для запроса, при этом функция объявлена основной частью поиска и не отключается пользователем. Google также заявляет, что стремится не показывать AI Overviews на «hard news»-темах, где критична свежесть.
Почему другие пользователи не всегда видят тот же funny AI answer
Разные users получают разные результаты в google ai errors funny по нескольким причинам:
- Персонализация и история поиска. Gemini использует прошлые запросы при включенной персонализации и активной Web & App Activity, что делает ответы уникально настроенными;
- Геолокация и язык. Выдача различается по стране, IP-адресу и языковым настройкам браузера.
«С 2024 по 2025 год доступность AI Overviews расширилась с 7 до 229 стран; Франция, Турция и ряд других крупных рынков по-прежнему оставались исключены». Источник: The Rise of AI Search: Implications for Information Markets and Human Decision-Making (2025) Хронология развертывания: 14 мая 2024 года запуск для всех пользователей в США; 28 октября 2024 года более 100 стран и территорий; май 2025 года более 200 стран и 40+ языков.
- A/B-тестирование. Google одновременно проверяет десятки вариантов интерфейса и версий модели Gemini на разных сегментах, распределяя пользователей по рандомизированным контрольным и экспериментальным группам;
- Авторизация. Результаты у пользователей, вошедших в аккаунт, отличаются от результатов в инкогнито, для части ИИ-функций Google требует авторизации;
- Языковые сбои детекции. Зафиксированы случаи, когда запрос на одном языке приводил к генерации AI Overview на другом, признак ошибки определения языка или подбора контента. Чтобы сравнивать инструменты генерации графики и видео по качеству, лимитам и правам использования, изучите сравнение AI-генераторов изображений и обзор лучших AI-арт-генераторов.
Можно ли полностью отключить AI Overviews
Официальная справка Google указывает: AI Overviews это основная функция поиска, и пользовательской настройкой она не отключается. Существующие обходные приемы (специальные операторы, вкладка «Web», сторонние расширения) не являются поддерживаемыми решениями и могут перестать работать после любого обновления интерфейса. Для организаций устойчивее не борьба с интерфейсом, а регламент верификации плюс мониторинг того, что ИИ-поиск говорит о вашем бренде.
Приложение A: исходные формулировки и уточнения
Для прозрачности редактуры ниже сохранены исходные версии фрагментов, уточненных в основном тексте:
- Исходно: «Согласно исследованиям распространения вирусного контента, некоторые скриншоты с funny ai overview fails собирают более 5 миллионов просмотров за считанные дни». Уточнение: подтвержденный случай, отдельный пост со скриншотом AI Overview, превысивший 5 млн просмотров (WIRED, 2024); массовая статистика по всем скриншотам отсутствует.
- Исходно: «Аудит ответов Google AI в теме ухода за детьми показал, что 89,4% сгенерированных ответов не содержат стандартных предупреждений». Уточнение: речь именно о доле ответов без предупреждений; следовательно, safeguards присутствовали лишь примерно в 11% случаев.
- Исходно: «Согласно исследованию публикаций в BMJ Quality & Safety, анализировавшему диалоговые ИИ-модели в поиске…». Уточнение: исследование выполнено на базе Bing Copilot; перенос выводов на Google AI Overviews корректен как указание на схожий паттерн, а не как прямая атрибуция.
- Исходно: «В 2026 году немецкий суд (Munich Regional Court) признал компании Google юридически ответственной…». Уточнение: прецедент требует независимой верификации по первоисточникам судебных решений; документированные финансовые последствия подтверждены в делах Wolf River Electric (март 2025) и Эшли Макайзека (2026).
- Удалено как дублирующееповторное описание кейсов с клеем и камнями в отдельном подразделе, содержание объединено с таблицей известных ошибок и разделом «Индекс хаоса». Освободившийся объем отдан бенчмаркам точности 2026 года, блоку аудиторского следа и разделу об ограничениях доказательной базы.